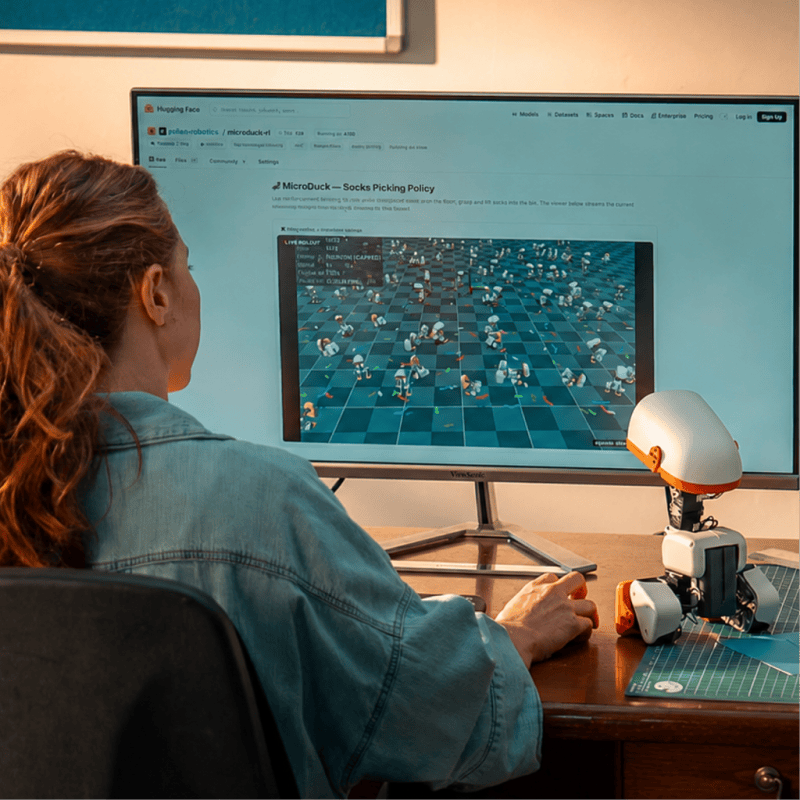
21 ตุลาคม 2026 ทีมของ NVIDIA เผยแพร่บทแนะนำบน Hugging Face ชื่อ Train in Simulation, Deploy on a Real Robot: Microduck with Isaac Lab 3.0 ซึ่งพาทำตั้งแต่ฝึกนโยบายการเดินในซิมูเลเตอร์ จนถึงคัดลอกไฟล์ลงหุ่นจริงแล้วสั่งให้เดิน สิ่งที่น่าสนใจไม่ใช่เทคนิคใดเทคนิคหนึ่ง แต่คือราคาของบันไดขั้นแรก
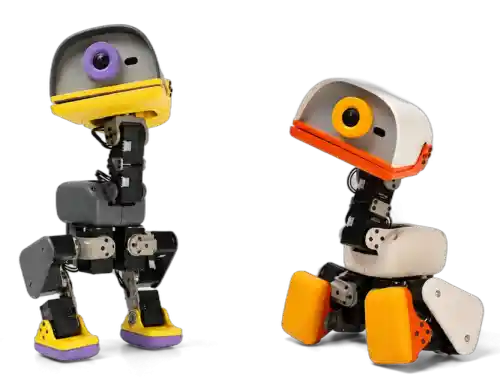
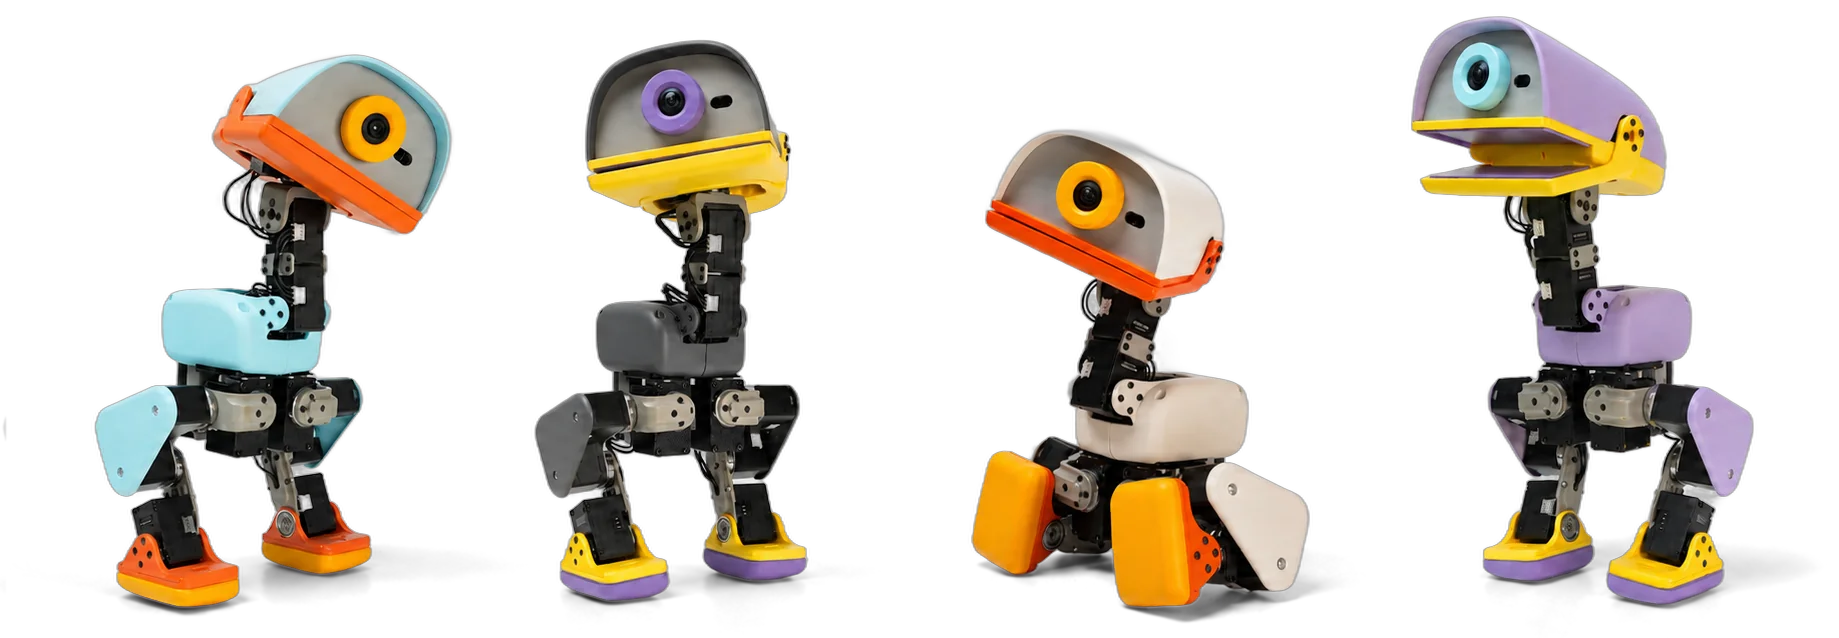
งาน sim-to-real เคยเป็นของห้องแล็บที่มีหุ่นฮิวแมนนอยด์หลักล้านเท่านั้น บทแนะนำนี้ใช้ Microduck หุ่นสองขาสูง 25 เซนติเมตร ที่ผู้ผลิตตั้งราคาไว้ 399 ดอลลาร์สหรัฐ แปลว่าโจทย์วิจัยที่เคยต้องเขียนของบหลายล้าน กลายเป็นโจทย์ที่ห้องเรียนหนึ่งห้องพอจะลองได้ บทความนี้สรุปว่าเวิร์กโฟลว์นี้ทำอะไรบ้าง ต้องเตรียมอะไร และข้อจำกัดอยู่ตรงไหน
ทำไม “ฝึกในซิมแล้วใช้งานจริง” ถึงยากกว่าที่คิด
นโยบายที่เดินสวยในซิมูเลเตอร์มักล้มทันทีบนหุ่นจริง เพราะซิมูเลเตอร์ทั่วไปสมมติว่าเซอร์โวตอบสนองทันทีและแม่นยำ ขณะที่ของจริงมีแรงเสียดทาน มีดีเลย์ของคำสั่ง แรงดันแบตที่ตกลงเรื่อย ๆ และระยะฟรีของเฟือง (backlash) คือช่วงที่ข้อต่อเปลี่ยนทิศแล้วชุดส่งกำลังขยับเล็กน้อยก่อนจะขบกันจริง
ช่องว่างนี้เรียกว่า sim-to-real gap และวิธีปิดช่องว่างที่บทแนะนำเลือกใช้ไม่ใช่การทำซิมให้แม่นขึ้นอย่างเดียว แต่คือการทำให้ซิมไม่แน่นอน แล้วบังคับให้นโยบายทนต่อความไม่แน่นอนนั้น
เวิร์กโฟลว์ทั้งหมดในหกขั้น
| ขั้น | ทำอะไร | เครื่องมือ |
|---|---|---|
| 1. ติดตั้ง | ติดตั้ง Isaac Lab บนเวิร์กสเตชัน Linux ที่มี GPU NVIDIA | Isaac Lab 3.0, uv |
| 2. เลือกงาน | ใช้สภาพแวดล้อมที่เตรียมไว้ให้แล้ว ทั้งพื้นเรียบและพื้นขรุขระ | IsaacContrib-Velocity-Flat-MicroDuck / -Rough-MicroDuck |
| 3. ฝึก | รันสภาพแวดล้อมขนานกันบน GPU พร้อมสุ่มสภาพแวดล้อม | Newton (ตัวแก้ MJWarp), RSL-RL |
| 4. ประเมินและส่งออก | ดูผลใน visualizer แล้วส่งออกไฟล์นโยบาย | ได้ทั้ง policy.pt และ policy.onnx |
| 5. เทียบผล | อัปโหลดโมเดลขึ้น Hub หรือส่งเข้าเวทีเทียบผล | Hugging Face Hub, Microduck Arena |
| 6. ลงหุ่นจริง | คัดลอกไฟล์ ONNX ไปที่หุ่น แล้วสั่งโหลดนโยบาย | scp, robotctl policy load |
จุดที่ควรสังเกตคือขั้นที่ 6 สั้นมาก เพราะรันไทม์บนตัวหุ่นโหลดไฟล์ ONNX ได้โดยตรง ไม่ต้องแปลงโมเดลหรือเขียนโค้ดเชื่อมเพิ่ม งานหนักทั้งหมดอยู่ที่ขั้นที่ 3
หัวใจอยู่ที่การจำลองเซอร์โวให้ “ไม่สมบูรณ์” แบบของจริง
บทแนะนำใช้โมเดลเซอร์โวชื่อ BAM (Better Actuator Models) ร่วมกับพรีเซ็ต backlash เพื่อแปลงคำสั่งตำแหน่งให้กลายเป็นแรงบิดที่สมจริง โดยจำลองทั้งตัวควบคุมในเฟิร์มแวร์ ขีดจำกัดทางไฟฟ้าของมอเตอร์ แรงเสียดทาน และดีเลย์
จากนั้นจึงสุ่มค่าต่าง ๆ ระหว่างฝึก (domain randomization) ได้แก่
- มวลและตำแหน่งจุดศูนย์ถ่วงของหุ่นแต่ละตัว
- ความฝืดของพื้น
- ความเฉื่อยของข้อต่อ
- ค่าชดเชยของเอ็นโค้ดเดอร์
- แรงดันแบตเตอรี่และการตกของแรงดัน
- ความหน่วงของคำสั่ง
- ภูมิประเทศ และแรงผลักที่กระทำกับตัวหุ่น
- backlash แยกอิสระรายข้อต่อ เพื่อแทนการสึกหรอที่ไม่เท่ากันในหุ่นจริง
ข้อสุดท้ายคือรายละเอียดที่แยกเวิร์กโฟลว์นี้ออกจากบทเรียน RL ทั่วไป หุ่นจริงที่ผ่านการใช้งานมาสักพักจะมีข้อต่อที่หลวมไม่เท่ากัน การสุ่ม backlash รายข้อต่อทำให้นโยบายไม่ยึดติดกับหุ่นตัวใดตัวหนึ่ง
ตัวเลขที่ต้องจำไว้ถ้าจะทำตาม
นโยบายรับค่าสังเกต 61 ค่า และสั่งตำแหน่งข้อต่อ 14 ค่า ต้องรักษาลำดับของค่าสังเกต การ normalize และสเกลของแอ็กชันให้ตรงกันระหว่างตอนฝึกกับตอนนำไปใช้ มิฉะนั้นหุ่นจะขยับผิดทันที ส่วนเวทีเทียบผล Microduck Arena รับเฉพาะโมเดลที่มีขนาดอินพุตและเอาต์พุตตรงนี้ และไฟล์ไม่เกิน 64 MiB
ต้องเตรียมอะไรบ้าง
- เวิร์กสเตชัน Linux พร้อม GPU NVIDIA รุ่นที่รองรับ ส่วนนี้ข้ามไม่ได้ การฝึกไม่ได้เกิดบนตัวหุ่น ตัวหุ่นแค่รันไฟล์ที่ฝึกเสร็จแล้ว
- งบเวลาสำหรับการฝึก ตัวอย่างในบทแนะนำรัน 4,096 สภาพแวดล้อมพร้อมกัน และระบุว่าเมื่อกระจายงานบน GPU 16 ตัว ทำความเร็วได้ถึง 1.25 ล้านสเต็ปต่อวินาที เครื่องการ์ดใบเดียวทำได้ แต่ต้องเผื่อเวลา
- หุ่นจริงที่ตั้งค่าเรียบร้อยและขาตั้ง บทแนะนำย้ำให้พยุงหุ่นไว้บนขาตั้งก่อนโหลดนโยบายใหม่ทุกครั้ง เพราะนโยบายที่ยังไม่นิ่งอาจทำให้หุ่นกระชากหรือล้ม
- คนที่คุ้นกับบรรทัดคำสั่ง ขั้นตอนลงหุ่นใช้
scpและsshตรง ๆ ไม่มีหน้าจอกราฟิก - แผนวัดผล ตั้งแต่ต้นว่าจะวัดอะไร เช่น ระยะที่เดินได้ก่อนล้ม หรือความทนต่อแรงผลัก ไม่อย่างนั้นจะได้แค่คลิปหุ่นเดินสวยแต่เทียบรุ่นต่อรุ่นไม่ได้
เอาไปใช้กับห้องเรียนไทยได้อย่างไร
ข้อได้เปรียบที่ชัดที่สุดคือต้นทุนของความผิดพลาด หุ่นหนัก 780 กรัมล้มบนโต๊ะแล้วมักไม่เป็นอะไร นักศึกษาจึงกล้าลองนโยบายที่ยังไม่นิ่ง ซึ่งเป็นสิ่งที่ทำไม่ได้กับหุ่นขนาดเท่าคนที่ล้มทีหนึ่งแล้วต้องส่งซ่อม
ข้อจำกัดที่ต้องพูดให้ชัดเช่นกัน หนึ่งคือยังต้องมีเครื่องฝึกที่มี GPU แยกต่างหาก ค่าใช้จ่ายไม่ได้จบที่ตัวหุ่น สองคือเอกสารทางการระบุเองว่าโมเดลขนาดใหญ่ทำงานอยู่นอกตัวหุ่น การที่ซอฟต์แวร์เป็นโอเพนซอร์สไม่ได้แปลว่าฟีเจอร์ AI ขั้นสูงทุกอย่างมีให้พร้อมใช้ และสามคือตัวเลขจำนวนมอเตอร์ 15 ตัวกับจำนวนค่าสั่งงานของนโยบาย 14 ค่าเป็นคนละตัวเลขกัน อย่านำไปสอนปนกัน
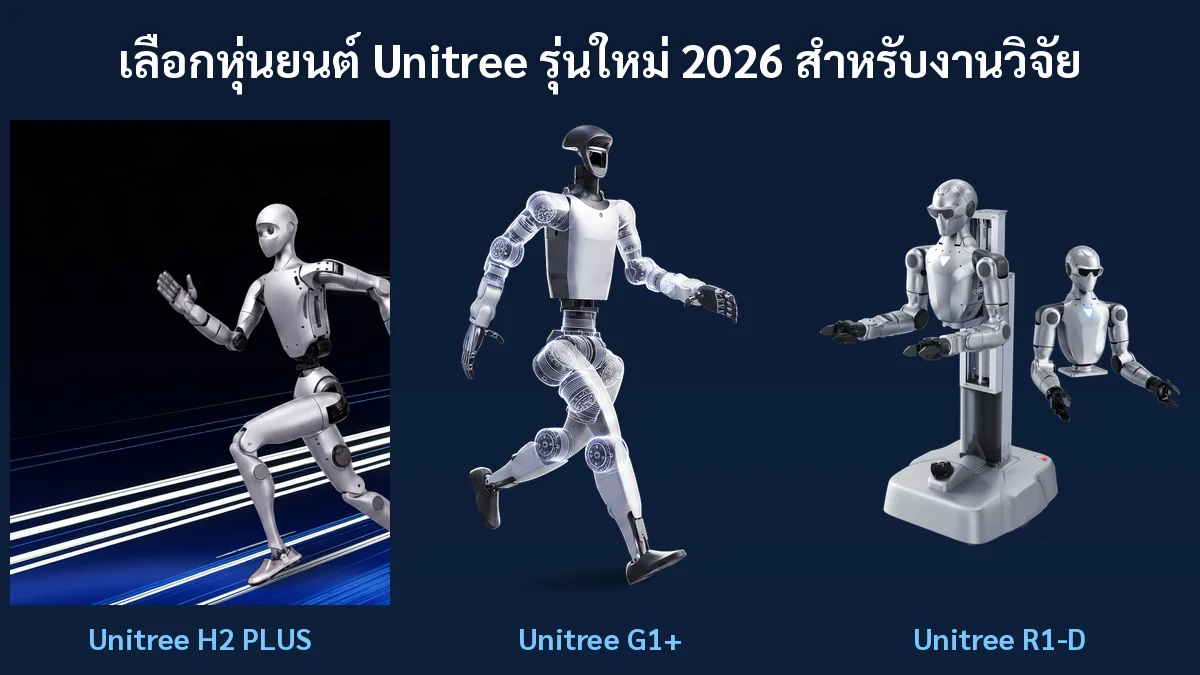
สำหรับสถาบันที่กำลังชั่งใจว่าควรลงทุนกับหุ่นแบบนี้เพื่อสอน Reinforcement Learning หรือไม่ เราเคยเขียนมุมงบประมาณและหลักสูตรไว้ที่ หุ่นยนต์เป็ด Microduck กับการสอน Reinforcement Learning: คุ้มไหมสำหรับสถาบัน และถ้าสนใจเส้นทางหุ่นขนาดใหญ่ขึ้น เทียบรุ่นได้ที่ คู่มือเลือกหุ่นยนต์ Unitree สำหรับห้องแล็บ
ดูสเปกเต็มและสอบถามการสั่งซื้อในไทย
สเปกฮาร์ดแวร์ รายการในกล่อง ชุดอุปกรณ์เสริม และเงื่อนไขการสั่งจองของผู้ผลิต รวบรวมไว้ที่หน้าสินค้า Microduck MD-01 หุ่นยนต์เป็ดสองขา 25 ซม. บน droneth.or.th ส่วนบทความภาพรวมราคาและวิธีสั่งซื้ออ่านได้ที่ หุ่นยนต์เป็ด Microduck ราคา สเปก และวิธีสั่งซื้อ
สรุป
บทแนะนำนี้ไม่ได้เสนอเทคนิคใหม่ที่ไม่เคยมีใครทำ แต่เป็นครั้งแรก ๆ ที่เวิร์กโฟลว์ sim-to-real ระดับงานวิจัยถูกจัดวางให้ครบตั้งแต่ติดตั้งจนถึงหุ่นเดินจริง บนฮาร์ดแวร์ที่ห้องเรียนหนึ่งห้องซื้อได้ ใครที่สอนหรือเรียน RL อยู่แล้วและมีเครื่อง GPU สักเครื่อง ควรอ่านต้นฉบับแล้วลองรันคำสั่งแรกดู ส่วนใครที่ยังไม่มีหุ่น ซิมูเลเตอร์ก็เริ่มได้ก่อนโดยไม่ต้องรอของ
เรียบเรียงจากบทความ “Train in Simulation, Deploy on a Real Robot: Microduck with Isaac Lab 3.0” ที่ทีมของ NVIDIA เผยแพร่บน Hugging Face เมื่อ 21 ตุลาคม 2026 ประกอบกับสเปกและเงื่อนไขการสั่งจองจากร้านทางการ microduck.shop ซึ่งดำเนินการโดย Pollen Robotics SAS · เป็นการเรียบเรียงจากเอกสารเผยแพร่ ไม่ใช่ผลการทดสอบฮาร์ดแวร์ของ DroneXR